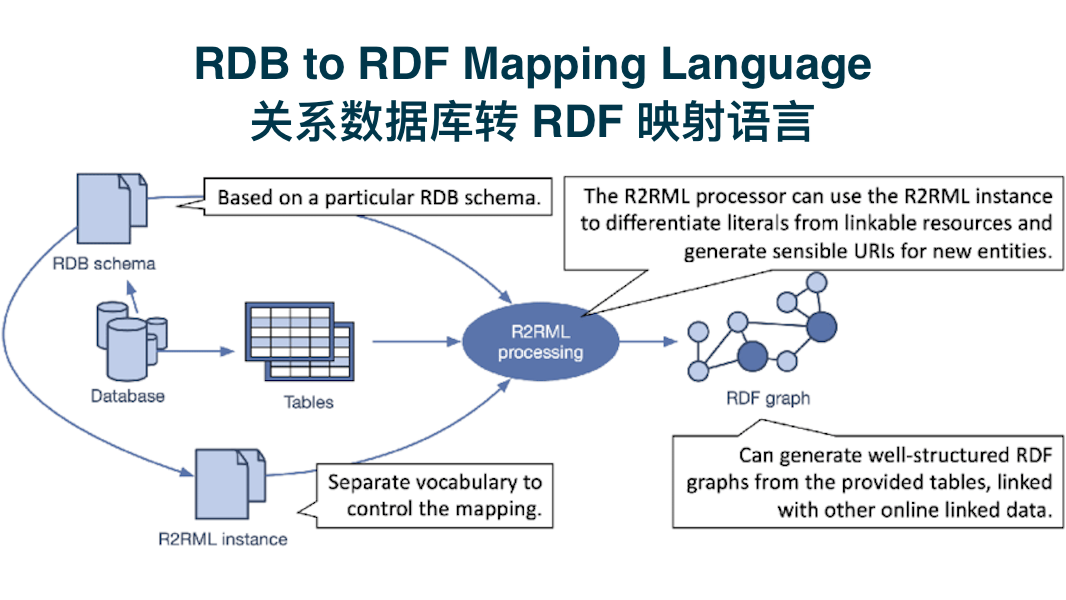
R2RML(RDB to RDF Mapping Language,关系数据库转 RDF 映射语言)是 W3C 于 2012 年正式发布的推荐标准,属于 RDB2RDF 技术体系核心规范,提供声明式的语义映射描述手段,将关系数据库(RDB)内结构化数据转换为 RDF 图数据,打通关系型存储与语义网知识图谱之间的鸿沟。不同于 Direct Mapping 直接映射(按表名字段名自动生成 RDF,不可定制),R2RML 支持自主定义本体、IRI 模板、关联规则,可把数据库表、视图、自定义 SQL 查询结果映射为符合领域本体的 RDF 三元组,实现传统业务数据的语义化发布、知识融合与 SPARQL 虚拟查询。
一、背景:关系数据与语义模型的割裂
关系数据库以二维表、行、列、主键外键为基础模型,擅长事务处理、结构化存储,是企业信息系统、政务、图书馆、科研平台最主流的数据载体;但其数据语义内嵌在表结构、字段注释与业务代码中,机器无法自动理解实体、属性、实体之间的语义关系,跨库数据融合困难。
RDF(资源描述框架)是语义网基础数据模型,使用三元组<主语,谓词,客体>描述世界中的资源,配合 OWL 本体定义概念、类、属性与约束,支持知识推理、关联数据互联。二者底层模型天然异构:
关系模型:面向记录、二维平面、强范式;
RDF 模型:面向资源、图结构、弱结构。
RDB2RDF 工作组提出两套互补方案:Direct Mapping 为默认自动映射;R2RML 为定制化语义映射语言,允许映射设计者脱离原始表名,对接领域本体词汇,把业务数据库 “翻译成” 知识图谱,而不需要改动原有业务库结构。R2RML 映射文档本身也是 RDF 图,一般使用 Turtle 语法编写,具备自描述性。
二、R2RML 语义映射核心概念
R2RML 映射由一组TriplesMap(三元组映射)构成,TriplesMap是最小映射单元,每一行逻辑表记录,生成若干 RDF 三元组。核心构件如下:
1.LogicalTable 逻辑表
逻辑表定义 RDF 数据来源,不局限数据库物理表。可以是:物理表、视图,或者一段原生 SQL 查询语句。
意义:打破物理表边界,支持多表 JOIN、过滤、聚合后再做语义映射,是 R2RML 灵活性的基础。
2.SubjectMap 主体映射
主体映射生成 RDF 三元组的主语(资源 IRI 或空白节点)。
支持模板(Template):利用数据库列值拼接生成全局唯一 IRI;
支持指定 rdf:type,映射到本体中的类(如ex:Person);
支持空节点(Blank Node)用于匿名资源。
例如模板http://example.org/person/{id},读取数据库id字段填充,为每一条人员记录生成唯一 IRI 标识实体。
3.PredicateObjectMap 谓词 - 客体映射
定义一组<谓词,客体>对,与主体组合生成完整三元组。内部包含:
PredicateMap 谓词映射:指定本体属性 IRI(如ex:name);
ObjectMap 客体映射:从字段生成客体,可以是文本字面量、数值、日期或 IRI;
RefObjectMap 引用客体映射:用于外键关联,通过rr:join连接多个逻辑表,把外键映射为实体间对象属性,实现 RDF 图中的实体关联,对应关系库外键。
4.TermMap 术语映射
SubjectMap、PredicateMap、ObjectMap 都属于 TermMap,用于生成 RDF 术语(IRI、字面量、空白节点)。TermMap 取值来源分为常量、列值、字符串模板三类,同时支持数据类型转换(字符串、int、date 等 XSD 类型)。
5.GraphMap 图映射
可选构件,用于将三元组归入指定命名图(Named Graph),支持多图隔离,便于分领域、分批次管理 RDF 数据集。
三、R2RML 语义映射两种运行模式
R2RML 处理器存在两种实现路线,在工程落地中差异显著:
物化模式(Materialized):处理器读取数据库,执行映射规则,批量生成 RDF 三元组,持久化存入 RDF 存储(三元组库)。优点:SPARQL 查询性能高;缺点:数据更新需要重新执行映射,存在数据延迟。适合静态、低频变更的档案、词表、历史科研数据。
虚拟模式(Virtual / On-the-fly):不生成物理 RDF,收到 SPARQL 查询时,R2RML 引擎将 SPARQL 反向翻译成 SQL,下发到源数据库执行,结果即时转换为 RDF 三元组返回。优点:实时访问业务库,数据零冗余;缺点:复杂 SPARQL 生成 SQL 难度大,查询性能受数据库索引影响。典型工具如 D2RQ、Ontop,广泛用于政务、企业实时语义查询场景。
两种模式共享同一套 R2RML 映射文件,映射规则一次编写,可按需切换物化 / 虚拟查询,这是 R2RML 声明式设计的巨大优势。
四、R2RML 映射示例(Turtle)
假设 MySQL 有一张person表:id, name, birth。
目标:映射为领域本体ex:Person,属性ex:fullName、ex:birthDate。
turtle
@prefix rr: .
@prefix ex: .
@prefix xsd: .
<#PersonTriplesMap> a rr:TriplesMap ;
rr:logicalTable [ rr:tableName \"person\" ] ;
rr:subjectMap [
rr:template \"http://example.org/person/{id}\" ;
rr:class ex:Person ;
] ;
rr:predicateObjectMap [
rr:predicateMap [ rr:constant ex:fullName ] ;
rr:objectMap [ rr:column \"name\" ] ;
] ;
rr:predicateObjectMap [
rr:predicateMap [ rr:constant ex:birthDate ] ;
rr:objectMap [ rr:column \"birth\" ; rr:datatype xsd:date ] ;
] .
当读取记录id=1, name=\"张三\", birth=\"1990-01-01\",自动生成三元组:
plaintext
rdf:type ex:Person .
ex:fullName \"张三\" .
ex:birthDate \"1990-01-01\"^^xsd:date .
五、R2RML 语义映射应用场景
关联数据发布:政务开放数据、图书馆元数据、档案系统,将存量业务数据库对外发布为遵循关联数据规范的 RDF 资源,支持浏览器、语义爬虫访问。
多源异构数据语义集成:多个独立业务库,通过统一本体 + R2RML 映射,把分散关系数据对齐到同一个知识图谱,实现跨库语义检索,而不需要 ETL 合并原始数据表。
知识图谱构建:企业知识库、术语词表、医疗 / 科研本体,作为知识图谱的数据接入层,把传统业务系统数据灌入图知识库。
语义查询层:在原有业务数据库之上搭建 SPARQL 语义查询接口,上层应用使用语义查询,底层仍然复用原有关系库,减少系统改造成本。
六、R2RML 的局限与技术演进
R2RML 局限
数据源受限:标准原生仅支持关系数据库,JSON、CSV、XML 等非关系数据无法直接描述;
表达能力边界:复杂聚合、高级语义转换、嵌套数据处理较为繁琐;
虚拟查询引擎优化难度高:复杂 SPARQL 到 SQL 的重写易产生低效 SQL,需要大量索引调优。
RML(RDF Mapping Language)扩展
RML 是 R2RML 社区扩展,向后兼容 R2RML,把rr:logicalTable泛化为rml:logicalSource,支持 CSV、JSON、XML、文件等各类异构数据源映射到 RDF,成为当前异构数据语义映射主流扩展方案。R2RML 仍是关系数据库场景的基准标准。
其他配套工具栈:Ontop、D2RQ、Morph-KGC、R2RML Parser,支持映射校验、可视化编辑、批量物化。
七、总结
R2RML 语义映射的本质,是用声明式规则完成关系模式到本体语义模型的转换。它不要求推翻成熟的关系数据库基础设施,而是在数据之上增加一层语义描述层,把二维记录 “提升” 为带语义关系的知识资源。
在知识图谱与语义应用工程体系中,R2RML 承担存量结构化数据的语义化桥梁角色:定义一次映射规则,支持批量导出 RDF 或提供虚拟 SPARQL 访问。随着异构数据需求增长,RML 扩展不断普及,但 R2RML 作为 W3C 官方标准,仍然是理解关系数据语义映射、设计数据库到知识图谱接入方案的基础理论。