聊Data Fabric(数据编织)的时候,“语义”大概是被大家用得最乱的词。不少厂商和项目,把字段备注、BI指标模型直接当成语义;元数据、语义层、本体、虚拟知识图谱VKG这几个概念经常混在一起,很容易踩坑:只做了字段文字说明,却指望系统自动完成跨库数据融合、逻辑推导,支撑NL2SQL和数据Agent。
Data Fabric的核心思路不是把所有数据搬去一个集中存储,而是数据留在原地,编织一套统一的业务含义、实体关系和业务规则。这里说的语义,就是一套机器能够读懂的业务含义体系。它主要解决两件大事:一是跨源术语消歧,解决不同系统里同名不是一个意思、同一个业务概念叫法不一样的问题;二是提供可推理的上下文,让系统能够根据定义推导出隐藏关系,支撑数据虚拟化、自动血缘、NL2SQL、数据Agent可信查询。
一、逐个理清概念:元数据、语义层、本体、VKG
1.元数据(Metadata):描述数据的数据,不等于语义
元数据可以理解成数据的档案卡片,回答这些问题:数据放在哪里、表结构是什么、负责人是谁、什么时候更新、访问权限,还有简单的文字备注、物理层面的数据血缘。
像表名、字段类型、存储地址、采集时间都属于元数据。但元数据大多停留在语法层面,只描述数据本身,不带业务含义,也没有逻辑推理能力。举个例子,订单表里面有个amount字段,元数据只会记录它是小数类型,没办法分辨这是订单总额、实付金额还是退款金额,也不能自动明白“客户创建订单,订单归属于这个客户”这种业务关系。
简单一句话:元数据描述数据的物理属性;语义描述这些数据代表什么业务意义。元数据是构建语义的原材料,但光有元数据,不等于有语义。
2.语义层(Semantic Layer):业务概念抽象模型,分两种完全不同的路线
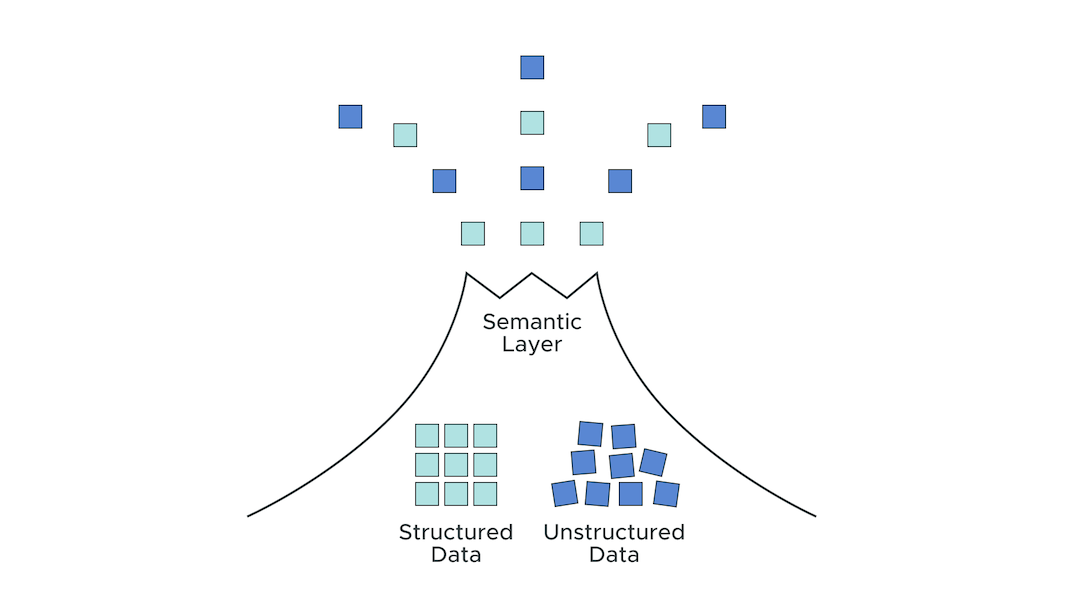
语义层的本质,就是在底层物理数据表之上,做一层业务抽象。把复杂的底层SQL、表关联、计算逻辑打包成业务词汇,屏蔽底层数据库复杂结构。
第一种是大家熟悉的传统BI语义层,也就是指标模型。它主要服务报表分析,目标很单一:统一指标计算口径。在这里定义维度、度量值、计算公式、过滤条件,保证多张报表算同一个指标结果一致,解决“同一个指标,不同人跑出不同数字”。模型一般用星型模型,重点在数值计算,实体之间的关系很弱,基本做不了复杂逻辑推理,使用者主要是人、BI可视化工具。
第二种是Data Fabric语义编织里的语义层。它不再只盯着指标,而是扩展到业务实体、实体关系、业务规则、同义词、业务约束;不再绑定单一数仓或者BI工具,可以对接MySQL、ERP、数据湖、API等各种各样的异构数据源,和数据虚拟化引擎配合,支持查询改写、逻辑推理、跨数据源联合查询。服务对象既包括人,也包括NL2SQL和数据Agent。
一句话区分:BI语义层解决指标算出来结果一致;Data Fabric语义层,让企业里所有业务概念全局可理解、跨源可查询、支持逻辑推理。
3.本体(Ontology,TBox术语盒):领域概念的知识骨架
本体,就是一套机器可读的领域词汇库,包含概念分类、实体关系和业务约束。它定义这个业务领域里面,有哪些类型的事物、事物有哪些属性、事物之间可以建立哪些关系,还有必须遵守的业务规则。
里面包含类别,比如客户、订单、商品;属性,比如客户手机号;关系,客户下订单;还有业务公理约束,例如订单必须关联客户、订单金额不能小于0。
这里要注意:本体只描述概念类型,不存放真实业务实例数据。在RDF知识体系里,本体属于TBox术语层;真实业务记录,比如客户张三、订单1001,属于ABox实例数据。本体是术语消歧和逻辑推理的底层规则。当ERP里的客户和CRM里的客户,映射到本体里同一个Customer概念,术语对齐就完成了;本体预先定义“订单归属客户”,系统就能推理:想要查询某个客户全部订单,需要关联两套异构系统里的客户实体。
本体只是一套模型规范,它本身不是查询引擎,不会直接去读取原始业务数据库。
一句话:本体定义业务世界有哪些事物,事物之间遵守什么规则,是语义的概念骨架。
4.虚拟知识图谱 VKG(Virtual Knowledge Graph):本体+映射+查询重写,原地虚拟生成知识图谱
VKG是Data Fabric语义能力最核心的载体,也最容易和传统物化知识图谱搞混。
传统物化知识图谱,是从各个数据源抽取数据,把实体、关系三元组全部落库存入图数据库。需要搬运数据、跑ETL任务定时同步,天然存在数据延迟。
虚拟知识图谱VKG,不迁移、不复制原始业务数据,数据仍然留在原来的业务库原地。依靠本体,搭配R2RML这类语义映射规则,把关系型数据库、数据湖里面的物理表,虚拟映射成本体定义的RDF三元组视图。当收到SPARQL或者自然语言查询时,VKG引擎会做查询重写,把图查询翻译成各个源数据库能识别的查询语句,下推到原始数据源执行,最后合并结果返回。
VKG具备这些核心能力:基于本体完成术语消歧;依托本体公理做逻辑推理,挖掘隐藏的实体关系;搭配数据虚拟化引擎,实现跨数据源联合查询;基于语义映射自动推导跨系统业务血缘;为NL2SQL、数据Agent提供可信业务上下文。
一句话:本体是知识模型,VKG是运行时引擎,负责把原地多源物理数据,实时虚拟转换成知识图谱视图。
概念之间的关系
元数据是基础原材料,本体搭建领域概念骨架,语义层封装业务概念和查询抽象,VKG依靠映射规则,把原始数据挂载到本体之上,形成一套可推理、跨源访问的虚拟知识视图。它们不是互相替代,而是层层叠加、互相依赖。
二、Data Fabric语义两大核心价值:术语消歧 + 可推理上下文
价值1:跨源术语消歧
企业里多套业务系统长期并存,术语冲突是常态。
有的是同名不同含义:ERP里的客户指签约付费客户,CRM里的客户包含潜在线索;
有的是不同名字但表达同一个业务概念:ERP应收金额,财务系统应收账款余额,描述的是同一个指标;
还有口径差异:同一个GMV,A业务线计算包含退款,B业务线剔除退款。
仅仅依靠人工备注、元数据标签,没办法让机器自动识别和解决冲突。语义体系,也就是本体加映射规则,可以建立全局统一业务概念ID,把不同数据源的字段映射到本体里同一个类或者属性。当Agent或者NL2SQL收到自然语言提问“客户应收总额”,系统不会简单模糊匹配所有表里名字相同的字段,而是通过本体定位对应的业务实体,选择正确数据源,规避口径混乱。
这是可信查询的基础:AI不是靠猜字段,而是匹配业务概念。
价值2:可推理上下文,支撑整套Data Fabric能力链
普通元数据、传统BI语义层,只能读取预先写死的显式关系,没办法推导隐藏事实;本体+VKG带来的推理能力,正是NL2SQL、数据Agent能否落地的关键。
依靠这套能力,首先实现数据虚拟化,查询不需要提前把数据集中整合;VKG把图查询重写成各个数据源原生SQL,下推计算,原地完成多源数据联合。其次实现血缘自动推导,不用人工维护录入血缘。依靠语义映射和本体关系,推理实体、指标、字段之间的业务血缘,不只是ETL层面的物理血缘。同时NL2SQL升级,大模型不再只依赖表名、字段名匹配,而是依靠本体业务词汇理解用户真实意图,召回正确实体和指标,减少幻觉。最后支撑Agent可信查询,Agent拿到可推理业务上下文、权限规则、业务约束。查询之前校验业务概念合法性,查询结果附带概念定义、口径说明、血缘链路,做到可解释、可审计,解决大模型查数黑盒幻觉的痛点。
重点提醒:没有推理能力的语义,只能做简单词汇匹配,不足以支撑企业级数据Agent。
三、传统BI语义层 vs Data Fabric语义编织
很多企业已经搭建BI语义层,很容易误以为它就是Data Fabric的语义底座,两者底层思路差别很大。
传统BI语义层,核心目标是统一指标计算口径,服务报表自助分析。建模重点是维度、度量值、计算公式,一切围绕指标来构建。数据源大多绑定单一数据仓库或者数据集市。推理能力很弱,只支持基础聚合计算,没有逻辑推理。查询方式面向SQL、DAX,查询预定义好的指标。对AI的支持有限,只能辅助基础NL2SQL,很容易出现字段匹配幻觉。血缘主要是ETL产生的物理血缘。适用范围局限在单个分析域,和BI工具深度绑定。
而Data Fabric语义编织,核心目标是全局业务概念对齐,跨源知识推理,支撑数据虚拟化和AI Agent。建模对象是实体、属性、关系、业务公理约束,以业务实体为中心。可以对接任意异构原地数据源,不需要数据集中存放。支持本体公理推理,可以挖掘隐藏关系、校验业务约束。可以混合SPARQL和SQL查询,自动改写查询语句下推到多源数据库。给大模型提供机器可读的业务知识,支撑可信Agent查询。同时自动生成业务血缘加上物理血缘。本体和业务概念可以在企业全域复用,跨业务域使用。
简单总结:传统BI语义层是面向数据消费侧的指标封装层;Data Fabric语义编织是面向全域数据空间的知识层。两者可以共存,BI指标模型可以纳入本体体系,接入VKG,并不是非此即彼的替换关系。
四、落地避坑:几个常见误区
第一个误区:给字段写业务注释,就等于做了语义。实际上字段注释属于增强元数据,只是一段自然文字,机器没办法自动消歧、做逻辑推理。
第二个误区:搭建物化知识图谱,把数据灌入图数据库,就是Data Fabric语义。物化KG需要搬运数据,带来同步延迟和维护成本;VKG是虚拟视图,数据不动,契合Data Fabric原地访问的设计思路。
第三个误区:本体要一次性建好企业完整全局模型。本体适合按业务领域迭代建设,优先落地客户、订单这类核心业务域,慢慢扩展。本体模型太大,反而维护成本极高,很难落地。
第四个误区:只要上线语义层,就能直接使用数据Agent。Agent可信查询,需要本体消歧、逻辑推理、权限控制、血缘、审计整套语义底座,单纯指标语义层,约束不住大模型幻觉,生产环境风险高。
五、总结
放在Data Fabric的框架里面看:
元数据,是描述数据的档案卡片;
语义,是一套机器可以读懂的业务含义体系;
本体,是语义的概念骨架,定义业务领域里的事物与规则;
语义层是业务抽象模型,BI语义层聚焦指标口径,Data Fabric语义编织扩展到实体与关系;
VKG虚拟知识图谱,是运行时引擎,依托本体映射,把原地多源数据虚拟成知识视图,实现跨源术语对齐和逻辑推理。
Data Fabric语义,价值不只是统一报表指标口径。它把散落在各个孤岛的数据,编织成一套机器可读、可推理、可校验的企业知识。这正是数据虚拟化、自动血缘、可信NL2SQL、企业数据Agent落地的底层基础。缺少这套语义底座,大模型查数只能停留在表名字段的文本匹配,很难做到生产环境可信可用。