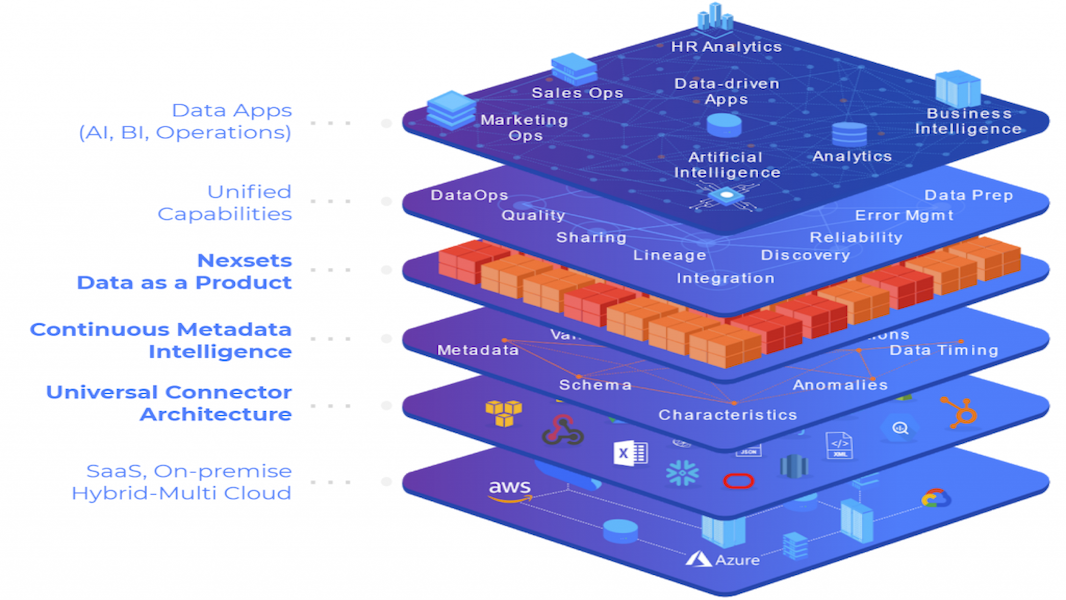
Data Fabric(数据织物/数据织网)是一套以元数据为核心、依托人工智能与自动化技术,实现全域数据互联互通、智能治理、动态调度的现代化数据架构。其核心价值在于打破传统数据系统的孤岛壁垒,无需物理迁移数据,即可完成跨场景、跨架构、跨云端的数据整合、溯源、管控与复用,是大数据、云计算与人工智能技术深度融合的产物。Data Fabric的发展并非一蹴而就,而是伴随企业数据量级爆发、业务场景复杂化、数据架构迭代升级逐步演进,从早期零散的数据集成探索,逐步成长为全球企业数字化转型的核心数据基础设施范式。
一、萌芽探索期(2010-2015年):传统数据架构的痛点倒逼变革
2010年之前,企业数据管理体系以数据仓库+ETL为核心范式,整体架构偏向集中式、结构化、人工驱动。企业通过固定的ETL流程抽取、清洗、结构化转换业务数据,统一存储至数据仓库,支撑报表统计、经营分析等基础场景。这一模式在数据体量小、格式单一、业务场景固定的时代,能够满足企业基础的数据管理需求。
2010年后,移动互联网、社交网络、电商平台快速崛起,数据产业迎来首次爆发式增长。数据形态从单一结构化数据,拓展为海量非结构化数据、半结构化数据;数据部署场景从本地机房,延伸至混合云、多终端、SaaS应用;数据需求从静态报表分析,转向实时分析、精准推荐、智能决策等动态场景。传统架构的弊端全面凸显:固定ETL流程灵活性极差,无法适配海量异构数据集成;集中式存储算力瓶颈突出,扩容成本高昂;人工主导的数据治理效率低下,数据孤岛、数据冗余、数据质量参差不齐等问题愈发严重。
行业开始探索新型数据集成方案,打破物理集中的数据管理思维。业内初步出现“分布式数据互联”“动态数据映射”的理念,摒弃传统全盘迁移、固化转换的模式,尝试通过轻量化连接技术打通分散的数据源。这一阶段是Data Fabric的技术萌芽期,尚未形成完整的概念与架构体系,但“数据就地利用、全域互联、灵活调度”的核心思想初步成型,为后续概念诞生奠定了技术基础。
二、概念成型期(2016-2020年):行业定义落地,架构体系初步构建
2016年是Data Fabric发展的关键元年,权威研究机构Forrester首次在行业报告中提出Big Data Fabric(大数据织物)概念,正式将其定义为面向大数据场景的分布式数据管理架构,标志着Data Fabric从零散技术探索升级为标准化行业概念。此时的核心定位是解决大数据场景下的异构数据集成难题,聚焦海量多源数据的统一接入与联动分析。
2016至2019年,行业持续完善概念内涵与技术框架,逐步剥离“大数据”的场景局限。随着企业数字化转型深入,数据治理不再局限于海量大数据场景,传统业务数据、云端数据、边缘数据的融合需求全面爆发。2019年,业内将Data Fabric重新定义为“分布式数据管理平台”,核心目标升级为全域数据资源的整合与协同,明确了元数据管理、数据智能发现、跨域数据联动三大核心技术模块,架构体系基本成型。
2020年,Forrester将报告中的“Big Data Fabric”正式迭代为Enterprise Data Fabric(企业级数据织物),完成了从“大数据专用架构”到“企业全域数据架构”的核心升级,贴合企业全场景数据管理需求。这一阶段,Data Fabric彻底摆脱了传统数据仓库、数据湖的技术局限,确立了逻辑统一、物理分布、动态互联的核心架构特征,与数据湖、数据网格等新型数据架构形成差异化发展路径。
三、标准化普及期(2021-2023年):权威定义定型,产业落地规模化
2021年,Gartner发布权威报告,对Data Fabric给出业界最经典、沿用至今的标准化定义:Data Fabric是一套集成的数据与连接流程架构层,依托元数据、知识图谱、人工智能技术,实现数据的自动发现、自动映射、智能治理与动态编排。此次定义明确了AI自动化、元数据驱动、业务语义关联三大核心核心特质,彻底完善了Data Fabric的理论体系,成为全球行业落地的核心标准。
这一阶段,行业清晰划分了Data Fabric与其他数据架构的边界:区别于数据仓库的物理集中、固化加工,Data Fabric以逻辑整合为主,兼顾灵活性与时效性;区别于数据网格的去中心化、团队自治模式,Data Fabric以统一架构平台为核心,更适配大中型企业的集中管控需求。同时,云计算厂商、大数据服务商纷纷入局,推出商业化Data Fabric解决方案,推动技术从理论走向落地。
2022至2023年,Data Fabric进入规模化落地阶段。全球头部企业率先应用于金融、制造、政务、零售等领域,解决多云部署、多系统割裂、数据治理成本高、数据复用率低等核心痛点。国内行业也快速跟进,将Data Fabric理念融入企业数据中台、数据要素平台建设,摒弃传统重存储、重迁移的建设模式,转向轻量化、智能化、可迭代的数据运营模式。至此,Data Fabric成为企业数字化转型、数据资产化建设的主流架构选型。
四、智能化成熟期(2024年至今):深度AI赋能,融入数据要素生态
2024年以来,随着大模型、生成式AI技术的普及,Data Fabric进入智能化升级的成熟阶段,核心演进方向从“自动化数据互联”升级为“智能化数据运营”。传统Data Fabric主要实现数据自动发现、血缘追溯、权限管控,而新一代智能Data Fabric依托大模型能力,实现自然语言数据查询、智能数据质量修复、业务语义自动匹配、数据价值智能挖掘等高阶能力,大幅降低数据使用门槛,让数据治理与数据分析从技术人员专属能力,转变为全员可用的普惠能力。
同时,Data Fabric的应用场景进一步延伸,深度对接数据要素市场化建设。区别于传统数据架构聚焦企业内部数据管理,当前的Data Fabric架构可支撑跨企业、跨行业、跨区域的数据安全共享与流通,通过统一的元数据标准、数据脱敏机制、权限管控体系,实现数据“可用不可见、可控可溯源”,适配政务数据共享、产业数据流通、数据交易等新型场景。
在产品生态层面,技术迭代持续加速,Microsoft Fabric、华为云Data Fabric、阿里云数据织物等主流产品持续更新迭代,形成成熟的商业化生态。架构兼容性、安全合规性、算力适配性持续优化,既能适配传统本地部署场景,也能完美适配多云、混合云、边缘计算等新型基础设施,成为打通数据资源、算力资源、业务场景的核心枢纽。
五、发展总结与未来趋势
纵观十余年发展历程,Data Fabric的演进本质是数据管理从人工驱动向智能自动化、从物理集中向逻辑协同、从内部管控向全域流通的变革过程。从2010年前的技术痛点积累,到2016年概念诞生、2021年体系定型,再到如今的智能化普及,Data Fabric彻底重构了企业数据管理模式,解决了传统架构灵活性差、治理成本高、数据价值难以释放的核心难题。
未来,Data Fabric将朝着三大方向持续演进:一是全场景智能化,深度融合大模型技术,实现数据全生命周期的无人化治理与价值自动挖掘;二是要素流通常态化,适配数据要素市场化需求,构建安全、合规、高效的跨主体数据流通架构;三是生态标准化,统一行业元数据、语义映射、安全管控标准,打破不同厂商、不同系统的技术壁垒,成为数字经济时代的通用数据基础设施。